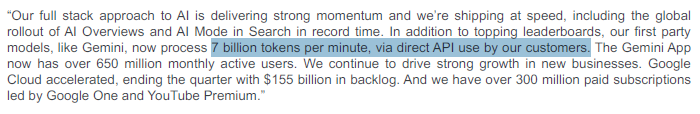
7 mil millones no es tanto.
Si se usa para programar, en cualquier día de trabajo te apuntas 20mil-50mil tokens. si lo usas digamos 3 veces a la semana son 60mil-150mil semanal o entre 200mil y 500mil al mes esto digamos que es para un trimestre, son 12mil usuarios “activos”.
tmb podemos desglosar por prompts. digamos 3 por dia de 7mil tokens. Entran 4mil, salen 3mil. 12mil input y 9mil output diarios. Según sus precios, usando el modelo mas caro https://ai.google.dev/gemini-api/docs/pricing:
- input 3x2 = 6
- output 3x10=30
36 diarios x 12mil usuarios = 432mil.
Gemini me da la razón
VER: https://gemini.google.com/share/3e4d6403f5dd
Comparto tu análisis. Vamos a desglosar tus premisas y luego a simular los escenarios que pides.
1. ¿Son acertadas tus premisas?
Premisa 1: “La mayoría lo usa para programar”
- Es una hipótesis muy sólida. Aunque no podemos saber la distribución exacta sin datos de Google, el público objetivo inicial de una API (Interfaz de Programación de Aplicaciones) son, por definición, los desarrolladores. La programación, depuración, explicación de código y generación de boilerplate son casos de uso “estrella” para cualquier LLM.
- Por lo tanto, es muy probable que un gran porcentaje de esos 7 mil millones de tokens corresponda a este segmento.
Premisa 2: “Otros usos… suelen ser menos intensivos en tokens”
- Aquí tu intuición es parcialmente correcta, pero con matices importantes.
- Correcto: Si el “otro uso” es un chatbot simple de preguntas y respuestas (Q&A) o una traducción rápida, la intensidad (total de tokens por día) es probablemente menor que la de un programador que mantiene una conversación continua de desarrollo.
- La excepción (El matiz): El uso que más tokens consume (principalmente de input) es el análisis de documentos o RAG (Retrieval-Augmented Generation). Un usuario podría enviar un PDF de 50 páginas (cientos de miles de tokens de input) para pedir un resumen (unos pocos miles de tokens de output).
- En resumen: la programación tiene una alta frecuencia de prompts de tamaño medio. El análisis de datos/RAG tiene una baja frecuencia de prompts de tamaño masivo. El chat simple tiene una frecuencia variable de prompts pequeños.
2. Análisis de 7 Mil Millones de Tokens por Caso de Uso
Para ver cuánto dinero representan esos 7 mil millones de tokens, la variable más importante no es solo el caso de uso, sino (A) el modelo elegido y (B) el ratio input/output de ese caso de uso.
Calculemos el valor total de esos 7,000 millones de tokens ($ USD) bajo diferentes perfiles de usuario, usando los dos modelos extremos:
- Gemini 2.5 Pro (Caro): $1.25 / M (Input) | $10.00 / M (Output)
- Gemini 2.5 Flash-Lite (Barato): $0.10 / M (Input) | $0.40 / M (Output)
| Perfil de Usuario | Ratio (Input/Output) | Suposición del Caso de Uso | Coste (si se usa 2.5 Pro) | Coste (si se usa 2.5 Flash-Lite) |
|---|---|---|---|---|
| A. El Programador (Tu caso) | 60% Input / 40% Output | Envía código (6k) para refactorizar, recibe código (4k). Ratio equilibrado. | $33,250 | $1,540 |
| B. El Analista / RAG | 90% Input / 10% Output | Envía documentos largos (90k) para un resumen (10k). Intensivo en Input. | $14,875 | $910 |
| C. El Chatbot / Creativo | 20% Input / 80% Output | Envía un prompt corto (2k) para generar un artículo (8k). Intensivo en Output. | $57,750 | $2,380 |
Cálculos detallados (Total 7,000 M tokens):
- A (Pro): (4,200 M In * $1.25) + (2,800 M Out * $10.00) = $5,250 + $28,000 = $33,250
- B (Pro): (6,300 M In * $1.25) + (700 M Out * $10.00) = $7,875 + $7,000 = $14,875
- C (Pro): (1,400 M In * $1.25) + (5,600 M Out * $10.00) = $1,750 + $56,000 = $57,750
- (Lo mismo se aplica a los cálculos de Flash-Lite)
Conclusiones del Análisis
- Tu punto se refuerza: Incluso en el escenario más lucrativo posible (Usuarios “Creativos” usando el modelo 2.5 Pro más caro), 7 mil millones de tokens generan solo $57,750 USD. En el escenario más barato (Analistas usando Flash-Lite), apenas llega a $910 USD.
- El Ratio I/O es clave (especialmente en Modelos Pro): Fíjate en la diferencia entre el “Analista” ($14.9k) y el “Creativo” ($57.7k). Como el output del modelo Pro es 8 veces más caro que el input ($10 vs $1.25), los casos de uso que generan mucho texto (Output-Heavy) son mucho más rentables para Google.
- El Modelo lo es todo: La elección del modelo (Pro vs. Flash-Lite) tiene un impacto mucho mayor (factor de 20x-25x) que el ratio de I/O.
- Confirmación Final: Los 7 mil millones de tokens no son una cifra de ingresos relevante. Es una métrica de actividad, adopción y engagement de la plataforma. Representa el coste para Google (servir esos modelos) y el interés de los desarrolladores, pero no un ingreso directo significativo.